28/03/2005
Machine learning og kunstig intelligens er indstillet til at transformere bankindustrien ved at bruge enorme mængder data til at bygge modeller, der forbedrer beslutningstagning, skræddersyr tjenester og styrker risikostyring. Potentialet er enormt; ifølge McKinsey Global Institute kan dette generere en værdi på over 250 milliarder dollars i banksektoren. Men denne teknologiske revolution har en bagside. Machine learning-modeller forstærker visse elementer af modelrisiko, og selvom mange banker har valideringsrammer til at vurdere traditionelle modeller, er disse ofte utilstrækkelige til at håndtere de unikke udfordringer, som machine learning-modeller præsenterer.
Mange finansielle institutioner går derfor forsigtigt frem og begrænser brugen af disse avancerede modeller til lavrisikoapplikationer som digital markedsføring. Denne forsigtighed er forståelig i lyset af de potentielle finansielle, omdømmemæssige og regulatoriske risici. En bank kan utilsigtet overtræde antidiskriminationslove og pådrage sig betydelige bøder. En bedre tilgang, og i sidste ende den eneste bæredygtige, er at forbedre og tilpasse den eksisterende risikostyring for at imødekomme disse nye udfordringer.
Nye risici kræver nye tilgange
Der er ingen mangel på overskrifter, der afslører de utilsigtede konsekvenser af nye machine learning-modeller. Fra algoritmer, der skabte et 'flash crash' for det britiske pund, til selvkørende biler, der fejlagtigt identificerede fodgængere. Årsagen til disse risici er den samme, som findes i alle machine learning-modeller: øget modelkompleksitet. Disse modeller behandler typisk langt større datasæt, herunder ustrukturerede data som naturligt sprog, billeder og tale. Algoritmerne er ofte langt mere komplekse end deres statistiske modparter, og de er bygget ved hjælp af nye softwarepakker, der kræver mere specialiserede færdigheder.
Svaret på denne kompleksitet behøver dog ikke at være overdrevent kompliceret. Hvis de forstås korrekt, kan risiciene forbundet med machine learning-modeller håndteres inden for bankernes eksisterende valideringsrammer med målrettede forbedringer. Det handler ikke om at genopfinde hjulet, men om at forstærke det. Ved at modificere eksisterende risikoelementer og tilføje nogle få nye, kan institutioner sikre, at de specifikke risici ved machine learning adresseres effektivt.
Seks nye elementer til moderne modelvalidering
For at tilpasse risikostyring til machine learning-æraen er der seks nye centrale elementer, som validatorer og risikostyringsfunktioner skal fokusere på. Disse repræsenterer de mest substantielle ændringer i en traditionel valideringsramme.
1. Fortolkelighed (Interpretability)
Machine learning-modeller har ry for at være 'sorte bokse' (black boxes). Afhængigt af modellens arkitektur kan de resultater, den genererer, være svære at forstå eller forklare. Forestil dig en bank, der udvikler en produktanbefalingsmotor for at hjælpe kunderådgivere med krydssalg. Hvis rådgiverne ikke kan forklare rationalet bag modellens anbefalinger, vil de sandsynligvis ignorere dem. De stoler ikke på modellen, hvilket fører til spildt indsats og tabte muligheder. I andre situationer, som f.eks. kreditvurdering, kan det have alvorlige juridiske og etiske konsekvenser at handle på uigennemsigtige anbefalinger.
Graden af krævet fortolkelighed er en politisk beslutning for banken, baseret på dens risikoappetit. Modeller, der bestemmer, om der skal ydes kredit, er underlagt lovgivning om fair långivning og skal kunne producere klare årsagskoder for et afslag. Omvendt kan en model, der anbefaler en produktannonce i en mobilapp, udgøre så lille en risiko, at en dybdegående forklaring ikke er nødvendig. Heldigvis er der sket betydelige fremskridt inden for metoder, der kan gøre selv komplekse modeller mere gennemsigtige, såsom LIME (Local Interpretable Model-agnostic Explanations) og Shapley-værdier.
2. Bias
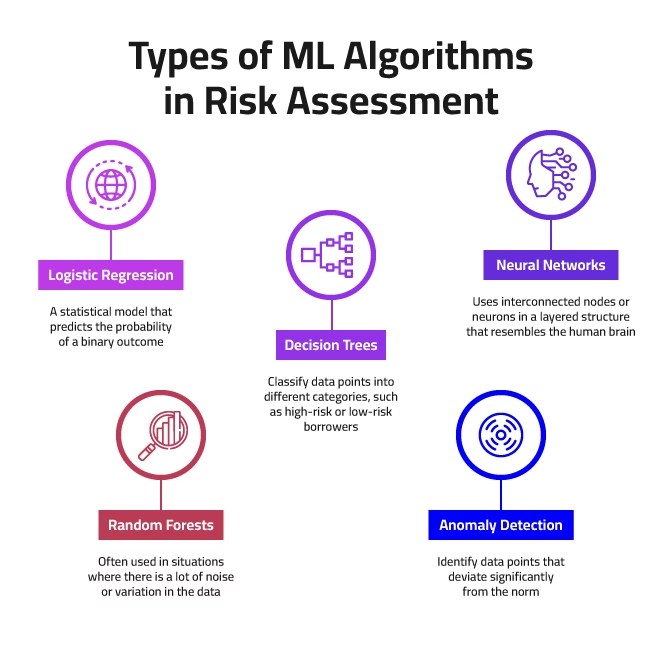
En model kan blive påvirket af flere typer bias, men især algoritmisk bias og bias mod grupper af mennesker kan blive forstærket i machine learning-modeller. For eksempel har Random Forest-algoritmen en tendens til at favorisere input med flere distinkte værdier, hvilket kan føre til forkerte beslutninger. En bank udviklede en model til at vurdere potentiel hvidvaskning af penge og fandt, at modellen prioriterede felter som 'erhverv' (med mange kategorier) over felter som 'land' (med færre kategorier), selvom sidstnævnte var en bedre prædiktor for risiko.
For at imødegå bias skal banker først beslutte, hvad der udgør retfærdighed. Der er flere almindelige definitioner:
- Demografisk blindhed: Beslutninger træffes uden brug af funktioner, der er korreleret med beskyttede klasser.
- Demografisk paritet: Resultaterne er proportionelt ens for alle beskyttede klasser.
- Lige muligheder: Sande positive rater er ens for hver beskyttet klasse.
- Lige odds: Både sande positive og falske positive rater er ens for hver beskyttet klasse.
Validatorer skal derefter sikre, at udviklere har taget de nødvendige skridt for at sikre retfærdighed gennem hele modellens livscyklus.
3. Feature Engineering
Processen med at udvælge og transformere inputvariabler (features) er ofte meget mere kompleks i machine learning. Dette skyldes, at modellerne kan inkorporere et langt større antal input, anvende ustrukturerede datakilder og bruge AutoML-platforme, der automatisk genererer tusindvis af komplekse features. Dette øger risikoen for unødvendigt komplekse modeller og overfitting, hvor modellen lærer støj i dataene i stedet for det underliggende mønster. Et eksempel er en institution, der byggede en model ved hjælp af en AutoML-platform og fandt, at specifikke bogstavsekvenser i en produktansøgning var prædiktive for svindel – et fuldstændig falsk resultat.
Banker skal fastlægge en politik for, hvor meget dokumentation der kræves for at fastslå den konceptuelle sundhed af hver feature. For en højrisiko kreditmodel kan det kræves, at hver enkelt feature vurderes for sin forretningsmæssige rationalitet. For lavrisikomodeller kan det være tilstrækkeligt kun at gennemgå selve feature engineering-processen.
4. Hyperparametre
Mange af parametrene i machine learning-modeller, såsom dybden af træer i en Random Forest-model eller antallet af lag i et dybt neuralt netværk, skal defineres, før træningsprocessen begynder. Disse kaldes hyperparametre. Deres værdier udledes ikke fra dataene, men baseres ofte på tommelfingerregler eller trial-and-error. En models ydeevne og stabilitet kan være ekstremt følsom over for de valgte hyperparametre. Validatorer skal sikre, at disse vælges så solidt som muligt, f.eks. ved hjælp af søgealgoritmer, der systematisk kortlægger parameterområdet, kombineret med ekspertvurdering og branchestandarder.
5. Produktionsparathed (Production Readiness)
Traditionelle modeller kodes ofte som simple regler i produktionssystemer. Machine learning-modeller er derimod algoritmiske og kræver meget mere beregningskraft. Denne tekniske detalje overses ofte i udviklingsprocessen. Udviklere bygger komplekse, prædiktive modeller kun for at opdage, at bankens produktionssystemer ikke kan understøtte dem. En amerikansk bank brugte betydelige ressourcer på at bygge en deep learning-model til at forudsige transaktionssvindel, blot for at opdage, at den ikke opfyldte de krævede latenstid-standarder (svartid).
Validatorer skal udvide deres vurdering til at omfatte den forventede datamængde, produktionssystemets arkitektur (f.eks. behovet for GPU'er til deep learning) og den krævede køretid for at sikre, at modellen er praktisk anvendelig.
6. Dynamisk Modelkalibrering
Nogle klasser af machine learning-modeller, såsom reinforcement learning-algoritmer, kan dynamisk ændre deres parametre for at afspejle nye mønstre i dataene. Dette erstatter den traditionelle tilgang med periodisk manuel gennemgang og opdatering. Risikoen er, at uden tilstrækkelig kontrol kan en overdreven vægt på kortsigtede mønstre skade modellens langsigtede ydeevne. Banker skal derfor beslutte, hvornår de vil tillade dynamisk rekalibrering. Det kan være passende for applikationer som algoritmisk handel, men for andre, såsom kreditbeslutninger, kan det kræve klare beviser for, at det overgår statiske modeller. Validatorer skal evaluere, om der er passende kontroller på plads, såsom tærskler, der fanger materielle skift i en models tilstand, og 'guardrails' som eksponeringsgrænser, der udløser en manuel gennemgang.
En gradvis vej fremad
Banker bør gå gradvist frem. Det første skridt er at sikre, at modelopgørelser inkluderer alle machine learning-baserede modeller i brug – mange banker bliver overraskede over, hvor mange de allerede har. Derefter kan valideringspolitikker og -praksis modificeres, i første omgang for et begrænset antal modelklasser. Dette hjælper med at opbygge erfaring, mens de nye politikker og praksisser testes og forfines. Over tid vil banker kunne anvende disse forbedrede rammer på hele spektret af godkendte machine learning-modeller, hvilket hjælper med at mindske risikoen og opbygge den tillid, der er nødvendig for at begynde at udnytte den fulde kraft af machine learning.
Ofte Stillede Spørgsmål (FAQ)
Er alle machine learning-modeller 'sorte bokse'?
Ikke nødvendigvis. Nogle modeller, som lineær regression, er i sagens natur lette at fortolke. For mere komplekse modeller som neurale netværk eller gradient boosting findes der i dag en række teknikker (f.eks. SHAP, LIME), der kan hjælpe med at forklare deres output og gøre dem mere gennemsigtige.
Hvad er den største risiko ved at bruge machine learning i banker?
Der er ikke én enkelt 'største' risiko, men en kombination af flere. Nøglebekymringer omfatter dog algoritmisk bias, der kan føre til uretfærdige eller diskriminerende resultater, og manglende fortolkelighed, som kan føre til dårlige forretningsbeslutninger eller manglende overholdelse af lovgivningen.
Skal vi bygge en helt ny risikostyringsramme for machine learning?
Nej, den gode nyhed er, at eksisterende rammer ofte er robuste nok til at blive tilpasset. I stedet for at starte forfra kan banker forbedre deres nuværende praksis ved at tilføje nye elementer, der specifikt adresserer de unikke risici, som machine learning-modeller introducerer, såsom bias-testning og krav til produktionsparathed.
Hvis du vil læse andre artikler, der ligner Risici ved Machine Learning i Banksektoren, kan du besøge kategorien Sundhed.